
Ловушка переобучения
Глава 5. 2001 год. Приходят люди с калькуляторами — и точность 90% превращается в 21%.
Цели урока
К концу этого урока вы:
- Что такое переобучение — без всякого жаргона, на простом примере
- Чем «выборка для обучения» отличается от «выборки для проверки» — и почему в 1998–1999 годах их вообще не различали
- Что именно нашёл Хейман в 2001-м: цифры, как он их получил, и что из этого следует
- Почему высокая «общая точность» может прятать за собой бесполезную модель
- Как переобучение связано с главной темой курса: описание держится, а предсказание — рушится
О, ты здесь! Отлично — у меня для тебя кое-что есть.
Ловушка переобучения
Осень 2001 года. На столе — уравнение Готтмана. Три года назад оно предсказывало развод с точностью 90%. Красивое число.
Психолог Ричард Хейман из Университета Стони-Брук с этим числом не спорит. Он делает то, что все почему-то пропустили: берёт других пар — не тех, на ком строилось уравнение, — и смотрит, сколько прогнозов сбудется теперь.
Общая точность и правда держится высокой. Но Хейман считает по-другому: из всех пар, которых уравнение назвало «обречёнными», сколько развелись на самом деле? Не 90%. Не 83%. Даже не 50%. Число — 21%.
Смотри, что это значит. Из каждых пяти пар, которых модель назвала обречёнными, четыре живут дальше как ни в чём не бывало. Уравнение, которое хвасталось точностью 90%, в этом смысле оказывается почти в четыре раза хуже, чем если бы просто гадать наугад — по одной лишь частоте разводов вообще.
Как такое возможно? Сейчас разберёмся. Потому что переобучение — не болезнь одной только психологии. Эту ошибку совершают везде, где строят прогнозы по данным. И заметить её изнутри почти невозможно — только со стороны.
Проверь память, прежде чем читать дальше
Что ты поймёшь после этой главы
- Что такое переобучение — без всякого жаргона, на простом примере
- Чем «выборка для обучения» отличается от «выборки для проверки» — и почему в 1998–1999 годах их вообще не различали
- Что именно нашёл Хейман в 2001-м: цифры, как он их получил, и что из этого следует
- Почему высокая «общая точность» может прятать за собой бесполезную модель
- Как переобучение связано с главной темой курса: описание держится, а предсказание — рушится
Часть 1. Портной, который шьёт по одному телу
Представь портного. Настоящего профессионала — дотошного, аккуратного. К нему приходит клиент. Портной снимает мерки: плечи, грудь, талия, длина рукава, наклон лопаток. Несколько недель кроит и шьёт. Костюм садится идеально — каждый шов на своём месте. Если бы существовал рейтинг точности пошива, этот портной получил бы 90 баллов из 100.
А теперь тот же костюм надевает другой человек. Случайный прохожий, примерно такого же роста и веса. И костюм не сидит: плечи перекошены, рукава длинные, спина топорщится. Откуда провал? Портной же был невероятно точен.
Вот это и называется переобучением. Модель — костюм, уравнение, прогноз, неважно — подогнана слишком плотно под те данные, которые уже видела. И теряет способность работать с новыми. Она запомнила конкретное тело вместо того, чтобы понять форму тела вообще.
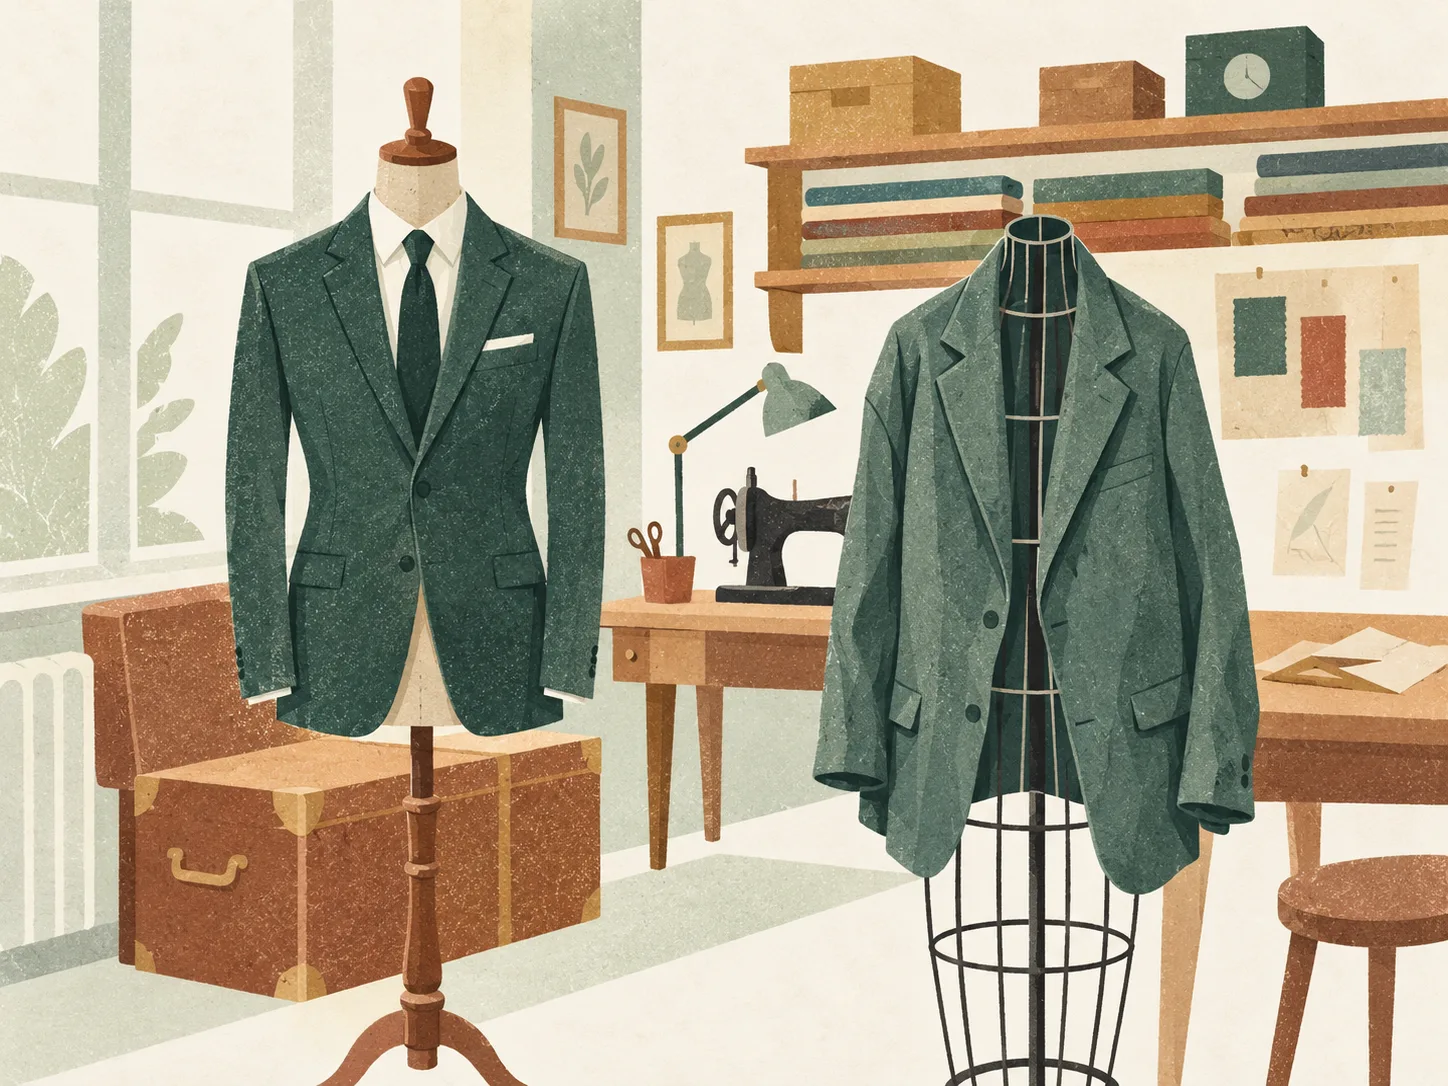
У Готтмана было так же. Уравнение 1998 года сшито точно по 130 парам, которые прошли через его лабораторию. Этих людей оно описывало идеально. Но когда Ричард Хейман и Эми Смит Слеп надели его на других людей — костюм повис мешком.
Часть 2. Что сделал Хейман — и почему это важно
В 2001 году вышла статья с сухим названием: «Опасности прогнозирования развода без кросс-валидации». Это тот самый разбор методики, которого не было ни в 1998-м, ни в 1999-м.
Хейман и Смит Слеп сделали несколько вещей. Во-первых, они разобрали, как было построено исследование Готтмана, — и нашли проблему в самой основе: выборки были маленькими и подобранными не случайно. Ключевые расчёты 1998 года строились всего на 60 парах — специально отобранных из крайних групп: либо явно счастливые, либо явно на грани развода. Это совсем не то же самое, что случайная выборка молодожёнов.
Во-вторых — и это главное — они сделали кросс-валидацию: взяли уравнение и проверили его на других парах, которые не участвовали в его создании. Общая точность (доля верно угаданных пар) осталась высокой. Но Хейман смотрел на другую цифру — положительную предсказательную ценность, сокращённо PPV: из всех пар, которых модель назвала «разводящимися», сколько развелись на самом деле?
Ответ: ~21%.
Что это значит на практике. Представь: психолог берёт уравнение Готтмана и проверяет 100 пар. Модель говорит: «Вот эти 20 разведутся». Если PPV — 21%, права она будет примерно в 4 случаях из 20. Остальные 16 пар назвали разводящимися зря. Это не прогноз. Это шум, только красиво упакованный в уравнение.
Часть 3. Почему «общая точность» обманывает
Но как так получается? Общая точность высокая, а предсказательная ценность всего 21%? На первый взгляд — парадокс. Разгадка — в том, как редко на самом деле случаются разводы.
Разводы — событие не такое частое, даже в американской статистике. Допустим, в реальности разводится 20% пар. Тогда модель, которая на все 100 пар просто говорит «никто не разведётся», уже права в 80 случаях из 100. Её общая точность — 80%. При этом она абсолютно бесполезна для предсказания разводов. Просто выглядит точной.
Готтман строил уравнение на своих 130 парах, а в его лабораторной выборке доля разводов была искусственно завышена — за счёт того самого перекоса в сторону крайних случаев. Уравнение научилось находить развод там, где видело его часто. А в обычной популяции, где разводов меньше, та же чуткость модели даёт кучу ложных тревог.
Часть 4. Три причины, по которым это произошло
Хейман и Смит Слеп нашли в работах 1998–1999 годов несколько проблем с методом. Стоит разобрать каждую — не для того, чтобы добить Готтмана, а чтобы понять, как вообще устроена наука и где в ней нужна осторожность.
Проблема 1. Маленькие и нерепрезентативные выборки
Ключевые расчёты 1998 года строились всего на 60 парах — специально отобранных из крайних групп: либо очень счастливые, либо очень несчастные. А пары со средним уровнем проблем, которых в жизни большинство, в эту выборку почти не попали. Уравнение научилось различать крайности, а не типичный случай.
Проблема 2. Отсутствие проверки на новых данных
По словам Хеймана, к 2001 году ни одно исследование ещё не проверяло предсказание развода на обычной, представительной выборке пар. Точность мерили на тех же данных, на которых строили модель. Это как если бы портной проверял костюм, снова надевая его на того же клиента, с которого снимал мерки.
Проблема 3. Слишком много факторов, слишком мало данных
Уравнение Готтмана учитывало много факторов сразу. А когда модель сложная, а данных мало, она легко «запоминает» случайные мелочи вместо настоящей закономерности — шум вместо сигнала. На новых парах этого шума уже нет, и точность падает. Это классическое переобучение.
Показательно, что статья Хеймана вышла в том же году, что и другая критическая работа — Стэнли, Брэдбери и Маркман написали, что советы из работы Готтмана 1998 года («откажитесь от активного слушания», «принятие влияния партнёра важнее компромисса») «как минимум преждевременны» и держатся на тех же слабых местах в методе. Особый вес этой критике придавало вот что: Говард Маркман, один из авторов статьи, сам был сооснователем программы PREP — программы профилактики семейных конфликтов. То есть критиковали не скептики со стороны, а свои же, изнутри профессии.
Часть 5. Верхняя дорога держится — нижняя рушится
Тут важно быть честным — за цифрами легко потерять главное. Хейман в 2001-м не говорит, что всё, что делал Готтман, — неправда. Он говорит точнее: часть программы, которая обещала предсказания, не прошла проверку на новых данных.
Верхняя дорога из карты главы 1 — описательные находки — при этом держится. Физиологическое сцепление как признак ссоры, которая идёт плохо (глава 1). Четыре всадника как поведение, которое отличает пары в кризисе (глава 2). Соотношение хорошего и плохого, связанное с удовлетворённостью браком (глава 3). Эти результаты получали разные учёные, разными методами, в разное время — и в целом они повторяются.
Нижняя дорога — «мы можем предсказать, кто разведётся, по первым трём минутам ссоры» — теста на новых данных не выдержала. Не потому что Готтман плохой учёный. А потому что переобучение — это обычная ошибка, которую делают даже умные люди. И потому что давление публичности, журналов, книг и ожиданий аудитории подталкивало к громким заявлениям быстрее, чем методика успевала их проверить.
Уравнение: «Зачем? Я уже проверилось. На этой».
Это и есть переобучение — самоуверенная модель, которая ни разу не выходила из родного города.
Часть 6. Что это значит для живых пар
Ты мог подумать: ладно, это всё какие-то академические споры. Какая разница, 83% там или 21%?
А дело вот в чём. Когда число «83% точности» попадает в популярные книги, тренинги и интернет-тесты — оно начинает жить своей жизнью. Пары читают статьи: «Если в первые три минуты разговора у вас жёсткий старт — вы в группе риска». Консультанты строят на этом целые программы. Выходят книги. Люди покупают онлайн-тесты, которые обещают «предсказать ваши шансы на развод».
Если реальная точность прогноза на новых парах — 21%, все эти программы, какими бы привлекательными они ни выглядели, стоят на шатком основании. Это не значит, что работать над отношениями бесполезно — к этому мы ещё вернёмся в финальных главах. Это значит только одно: конкретным цифрам-прогнозам доверять не стоит так сильно, как им доверяли.
Итоги главы 5
Переобучение: красивое число, ненадёжный прогноз
Точность 90% на своих данных превратилась в 21% верных прогнозов на новых. Это не ошибка вычислений — это ошибка дизайна: модель обучалась и проверялась на одних и тех же данных.
Три причины, которые привели к этому
Маленькие, специально отобранные выборки (всего 60 пар из крайних групп); отсутствие проверки на новых данных (к 2001 году — ни одной на обычной популяции); слишком сложная модель при слишком малых данных.
Критика изнутри профессии
Стэнли, Брэдбери и Маркман, 2000 год: рекомендации Готтмана «как минимум преждевременны». Маркман, соавтор программы PREP, критикует не потому что конкурент — а потому что стандарты важны для всех.
Верхняя дорога остаётся
Описательные находки — сцепление из главы 1, всадники из главы 2, соотношение 5:1 из главы 3 — держатся. А вот предсказательная часть — нет. Это и есть главная тема всего курса.
В следующей главе. 2007 год. Ким, Капальди и Кросби берут 85 независимых пар — не новобрачных из Сиэтла, а пары из группы риска, из совсем другого города и другой лаборатории. Они проверяют не одно уравнение, а сразу 22 эмоциональных процесса из программы Готтмана. Подтверждаются только два из двадцати двух. Что это значит для всей программы — и почему провал повторной проверки это не приговор, а начало разговора — в главе 6.
Как вам этот урок?
Один короткий сигнал поможет улучшить следующую версию.